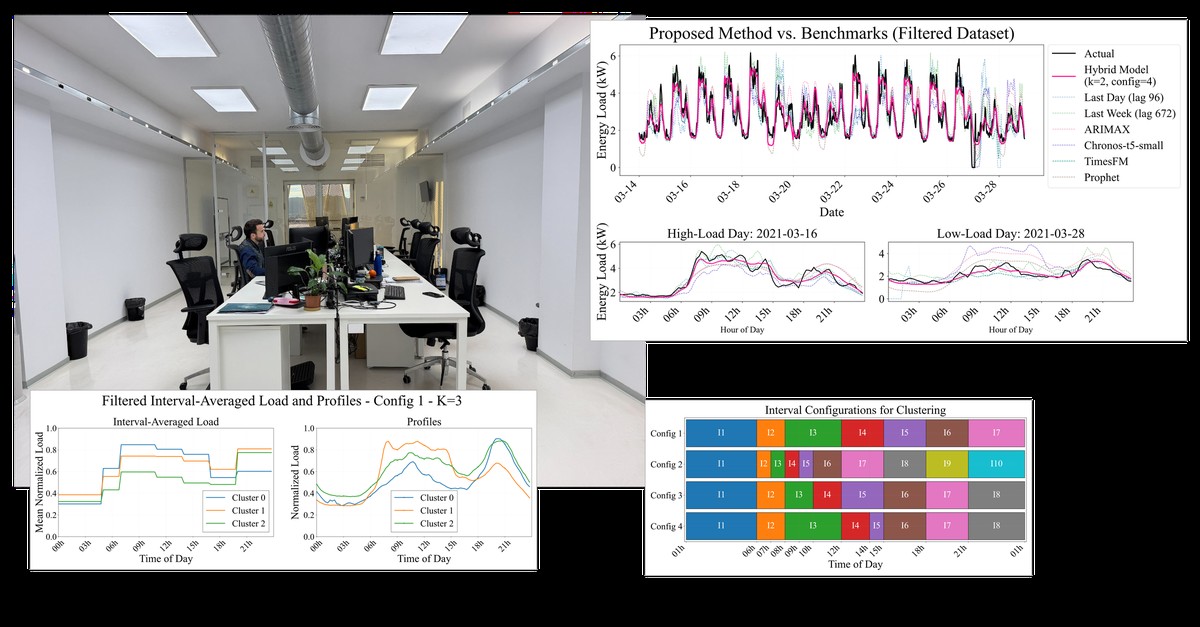
Siguiendo con los refranes, está lo de encontrar una aguja en un pajar…
Llevamos tiempo trabajando en modelos de predicción del consumo energético de edificios. Si lo predecimos, lo podemos gestionar…(lo de siempre).
Pero hay un problema que subyace, los humanos somos bastante impredecibles. Hoy llegas tarde al trabajo porque te has topado con un amigo de la infancia…y cómo no te ibas a tomar un café…total, que has encendido la climatización 30’ más tarde. Y nuestro modelo se ha ido a la (censurado).
Asi pues, nuestros trabajos sobre edificios enteros y grandes centros comerciales son correctos, y dan como resultado modelos simples e interesantes. Pero esconden la dificultad de predecir lo pequeño. Lo cual empieza a ser relevante cuando intentas ahorrar energía comprendiendo el comportamiento individual de cientos de personas. Básicamente el objetivo de las comunidades energéticas con gestión activa de la demanda, así cómo los conceptos de agregación de demanda y potencial de flexibilidad que estamos trabajando en el proyecto STUNNED.
Aquí nos encontramos con un número relevante de familias y pequeñas oficinas en las que hay que predecir el consumo. Y a ello nos hemos puesto. Lo de las familias lo dejo para otro día, porque entre fotovoltaica, vehículo eléctrico, bombas de calor,…da para una novela. Hoy me quedo con las oficinas.
Pregunta ¿Se puede predecir el consumo eléctrico de una oficina pequeña? De esas que tiene 6-8 ordenadores, un aparato de aire acondicionado y un microondas. Aquí, si una persona se encuentra con su amigo de la infancia,…automáticamente el 10-20% del consumo bascula. Esperemos que no todos vayan a la jornada de antiguos alumnos a la vez.
Pues esta pregunta le hicimos a Aitor Diez. Aitor es un alumno brillante de Ciencia de Datos e Informática e Deusto, y nos propusimos retarle (para que nos resolviese un problema). Ana García (Voltiva) tenía datos de múltiples oficinas, Cruz Borges había trabajado segmentando perfiles de consumo eléctrico, y yo mismo en el desarrollo de modelos de climatización (y algo de segmentación).
La idea principal es similar a la que desarrollamos conjuntamente con Mikel Lumbreras hace hay un tiempo. Pero el diablo está en los detalles. Las curvas eléctricas son mucho más dinámicas que los consumos de calor, la climatización de una oficina en Murcia se opera de una forma totalmente distinta a un sistema de calefacción en Estonia (dicen que el clima es ligeramente distinto), 6-8 personas agregan mucha menos demanda que 30-40 apartamentos en un bloque de viviendas, y además la carga eléctrica incorpora climatización y el resto de usos eléctricos. Incluso el microondas. Casi nada.
Aquí tuvimos suerte con la experiencia de Cruz. Que había tenido todo el proyecto WHY para pensar en esto y tenía ganas de contárnoslo: Básicamente, que el ser humano es más predecible de lo que pensamos. Y que los perfiles de oficinas se pueden definir con unos pocos descriptores: Cuanto se consume por la mañana, Cuanto por la tarde, a qué hora viene la gente a trabajar, si todos comen a la vez,…Con lo que los perfiles se simplifican:
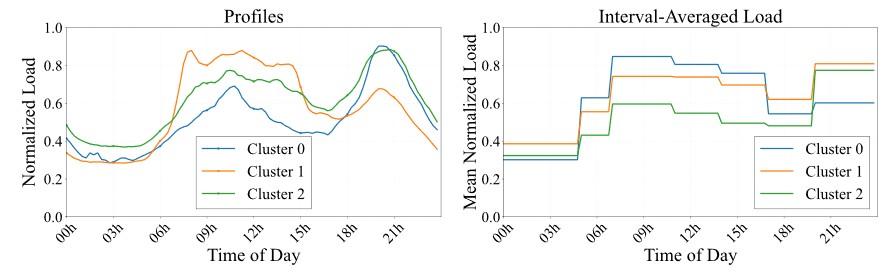
Nuestra metodología acabó siendo la siguiente:
- Normalizar los patrones de uso.
- Identificar los descriptores de cada curva diaria
- Clusterizar los patrones de consumo en base a los descriptores
- Generar una curva “típica” para cada cluster
- Aplicar la curva “típica” a cada día
Pero faltan dos pasos clave:
- Predecir el tipo de día que tocará mañana
- Desnormalizar el patrón
Y aquí cada uno aportó lo que sabia:
- Cruz nos propuso 3-4 formas de describir las curvas (y las probamos todas)
- Descubrimos que la regresión lineal múltiple sigue siendo una buena forma para predecir la demanda pico y desnormalizar las curvas
- Y Aitor probó varios métodos de Machine Learning para predecir el tipo de día.
Y funcionó. Aunque todo es mejorable y seguiremos mejorándolo:
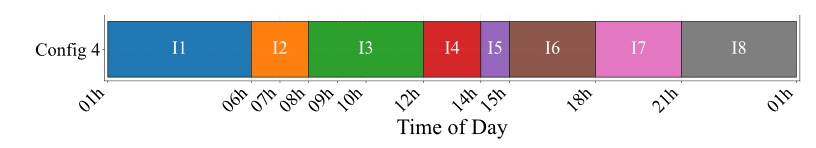
Los períodos relevantes para clusterizar fueron los siguientes:
- La noche (I1 e I8)
- Un período transitorio a primera hora del día (I2) de 6 a 9h. Sorprende no necesitar más sensibilidad en relación con las horas de entrada.
- La mañana (I3)
- Dos períodos de comida (I4 e I5), potencialmente como indicador de perfiles com pausa de comida corta (I4) y larga (I4+I5)
- La tarde (I6)
- Esos días en los que alguien te pide que te quedes hasta tarde (I7)
Con todo, la mejor calidad de predicción se consigue con dos clústeres. Principalmente vinculados a la necesidad de calefacción.
Y en general, nuestro modelo parece funcionar bastante bien. Mejorando a los predictores Naives, así como a modelos de series temporales y de ML complejos.
Aunque no lo tenemos suficientemente motivado, pensamos que tiene algo que ver con la especialización de componentes de nuestro modelo, y cómo planteamos cada uno basándonos en nuestro mejor conocimiento experto.
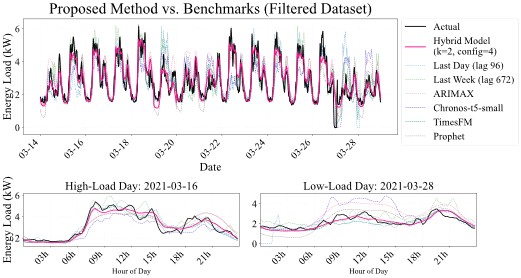
Con un alumno excelente, los datos y el apoyo de ingeniería de Ana y la base matemática de Cruz, esto ha sido una gozada. Si tienes más interés, pulicamos un artículo hace unos meses en ITISE, y Aitor ha liberado el código:
- Paper: Diez Mateo, A.; Garay-Martinez, R.; Borges, C.E.; García Garre, A. Hybrid Machine Learning Approach for Short-Term Load Forecasting in Small Commercial Buildings. ITISE, Gran Canaria, Spain, 2026, https://doi.org/10.3390/engproc2026155004
- Código: https://github.com/aitorDiezMateo/clustering-hybrid-load-forecasting.git
Para este año nos queda seguir: Ana nos ha amenazado con datos de más oficinas, y Aitor tiene el interés de plantear un modelo que se autocorrija. Pero esto lo dejamos para presentarlo el año que viene.